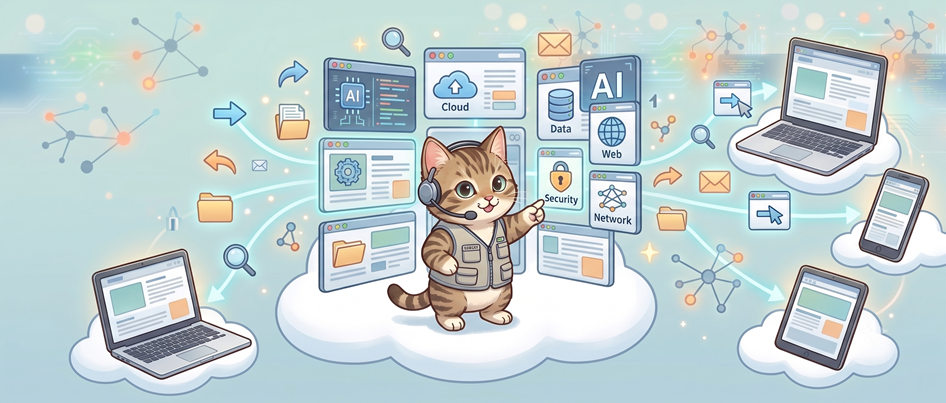
クローラー(Crawler)とは、Web上のページを自動でリンクをたどりながら巡回し、情報を収集するプログラムのことです。「ボット」や「スパイダー」とも呼ばれ、人が1件ずつ見て回る代わりに、機械が休みなくWeb全体を歩き回っています。
現実世界に例えると、クローラーは町中の掲示板を毎日巡回する情報収集係のようなものです。1枚1枚の貼り紙を読み、新しい貼り紙があれば内容を控え、古い貼り紙が剥がされていれば記録から外す、という作業をひたすら繰り返しています。
基本の動き方
クローラーはあるページのリンクをたどって次のページへ進むという単純な動作を繰り返します。起点となるページから枝分かれするように次々とリンクを追いかけ、Web全体に広がっていきます。
検索エンジンだけの道具ではない
クローラーというと検索エンジンのイメージが強いですが、実際には価格比較サイトの相場収集、ニュースまとめサイトの記事収集、著作権侵害の監視など、さまざまな用途で使われています。
robots.txtによる制御
サイト運営者はrobots.txtというファイルを置くことで、「このページは巡回してほしくない」という意思をクローラーに伝えられます。ただしこれは紳士協定に近く、従わないクローラーも存在します。
クロール予算という考え方
大規模な検索エンジンのクローラーは、1つのサイトに無制限に訪れるわけではありません。サイトごとに割り当てられる巡回の頻度や上限は「クロール予算」と呼ばれ、更新頻度や表示速度によって変動します。
良いクローラーと迷惑なクローラー
| 種類 | 特徴 |
|---|---|
| 良いクローラー | robots.txtに従い、負荷をかけすぎないよう間隔を空けて巡回する。 |
| 迷惑なクローラー | ルールを無視し、短時間に大量アクセスしてサーバーに負荷をかける。 |
サイト運営者にできる対策
robots.txtの設置に加えて、サイトマップ(sitemap.xml)を用意すると、正規のクローラーがページを見つけやすくなります。逆に迷惑なクローラーに対しては、アクセス元を制限するといった対策が取られます。
代表的なクローラー
GoogleのGooglebot、MicrosoftのBingbotなどが代表例です。それぞれの検索エンジンが自前のクローラーを運用しており、動き方や巡回頻度には違いがあります。
アクセスログに残る記録
サイトのアクセスログを見ると、人間の閲覧とは違う一定間隔での訪問が記録されていることがあります。これは多くの場合クローラーの巡回で、どのクローラーがいつ来たかを確認すれば、検索エンジンにきちんと見つけてもらえているかの手がかりになります。
あわせて知っておきたい用語
- 検索エンジン(Search Engine):
クローラーが集めた情報をもとに、検索結果を表示する仕組みです。 - SEO:
クローラーに見つけてもらいやすく、正しく評価されやすくする工夫です。 - robots.txt:
クローラーに巡回してほしくないページを伝えるためのファイルです。 - スクレイピング:
Webページから特定のデータだけを抜き出して収集する行為です。
コメント