

アスキーコード(ASCII Code)とは、アルファベットや数字、記号の一つひとつに番号を割り当てた、もっとも基本的な文字コードの取り決めのことです。1963年にアメリカで定められ、いまのコンピューターが扱う文字の土台として、六十年以上にわたって使われ続けています。
現実世界に例えると、アスキーコードは全員で取り決めた共通の暗号表のようなものです。送る側と受け取る側が同じ表を持っていれば、番号だけをやり取りしても、元の文章を正しく組み立て直せます。
アスキーコード図解
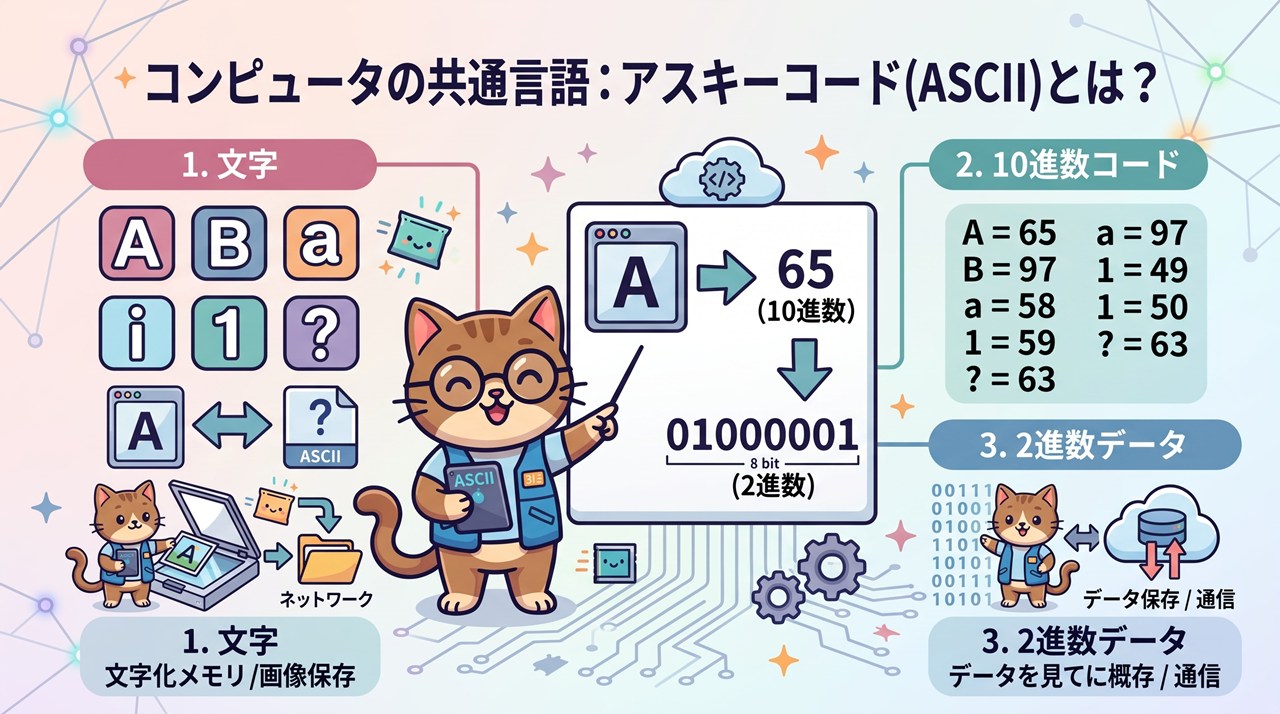
割り当ての内訳
| 区分 | 番号 | 内容 |
|---|---|---|
| 制御文字 | 0〜31 | 改行やタブなど、画面に出ないもの |
| 記号と数字 | 32〜64 | 空白、感嘆符、0から9など |
| 大文字 | 65〜90 | AからZ |
| 小文字 | 97〜122 | aからz |
7ビットで128文字を表す
規格の骨格がここにあります。0から127までの128通りで文字を表す設計で、1バイトの8桁のうち7桁を使い、残りの1桁は誤りの検出に充てる想定でした。数を絞ったのは、当時の通信回線や記憶装置の容量が、いまとは比べものにならないほど限られていたからです。
目に見えない文字がある
意外に思われる部分です。番号の前半には、改行、タブ、削除といった「動作を指示する文字」が並んでおり、これらは画面に形として現れません。文章の見た目は同じなのにファイルの中身が違う、という現象の多くは、この見えない文字の違いによって起きています。
大文字と小文字は32違い
知っていると役に立つ性質です。同じ文字の大文字と小文字は、番号がちょうど32だけ離れて並んでいます。そのため、大文字と小文字を入れ替える処理は、番号を足し引きするだけで済みます。文字を数値として扱えることが、プログラムの上で大きな利点になっています。
日本語を表すには足りない
限界もはっきりしています。128通りではひらがなも漢字も入りきらないため、日本では独自に拡張した文字コードがいくつも作られ、その乱立が文字化けの原因になりました。シフトJISやEUC-JPといった呼び名は、この拡張の系統の違いを表しています。
UTF-8に受け継がれている
現在との関わりが深い点です。いま主流となっているUTF-8は、最初の128文字をアスキーコードとまったく同じ並びにしてあります。そのおかげで、英数字だけで書かれた古いファイルは、そのままUTF-8としても正しく読めます。互換性を保つための、よく練られた設計といえます。
通信や設定ファイルで今も現役
使われる場面は減っていません。機器同士のやり取りの取り決めや、設定ファイル、プログラムの記述は、いまも英数字だけで書かれることがほとんどです。日本語を含まない範囲であれば、どの環境へ持っていっても化けずに読める安心感があり、あえてこの範囲に留める運用も行われています。
文字化けを調べる手がかりになる
実務での使いどころを挙げます。文字が崩れて表示されるとき、データを番号の並びとして見ると、どこまでが正しくどこから崩れたかを突き止められます。英数字の部分だけが読めて日本語が崩れている場合は、文字コードの取り違えが原因だと見当を付けられます。
コメント