

再帰処理(Recursive Processing)とは、ある処理(関数)が、自分自身をもう一度呼び出しながら答えを求めていくプログラミングの手法のことです。大きな問題を、同じ形をした少し小さな問題に分解して解いていく考え方が特徴です。
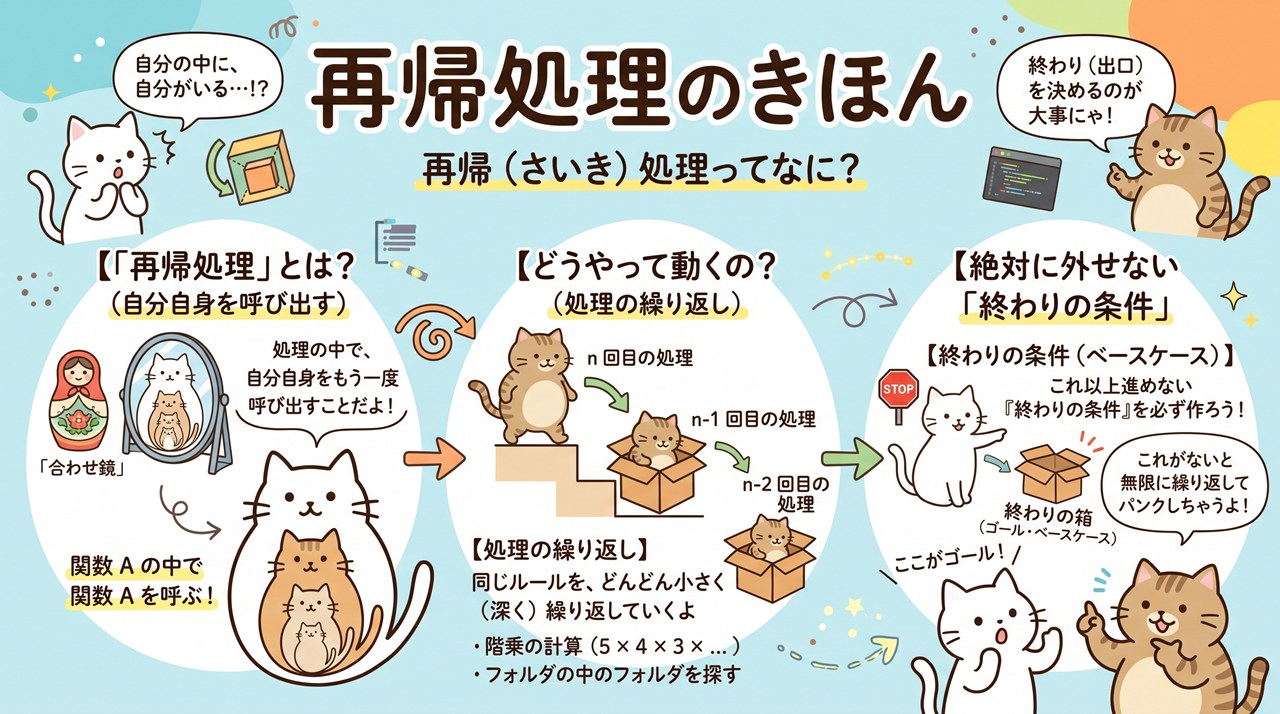
現実世界に例えると、再帰処理は合わせ鏡のようなものです。鏡の中にまた同じ鏡が映り、その中にさらに同じ鏡が映る、この繰り返しのように、同じ処理が自分自身の中に入れ子になって続いていきます。
再帰処理 図解
※画像をクリックすると拡大表示します。
再帰処理の特徴
再帰処理の最大の特徴は、「大きな問題」を「同じ種類の、少しだけ小さな問題」に置き換えて考える点です。1つの関数の中で自分自身を呼び出す処理を書くことで、複雑な繰り返しの構造を、驚くほどシンプルなコードで表現できることがあります。
再帰処理の仕組み
再帰処理では、関数が自分自身を呼び出すたびに、少しずつ問題の規模を小さくしていきます。呼び出しが繰り返されるたびに新しい処理が積み重なっていき、最終的にこれ以上分解できない一番小さな状態に到達すると、そこから答えを積み上げるようにして結果が返されていきます。
基底条件(終了条件)の重要性
再帰処理には、「これ以上自分自身を呼び出さず、答えを直接返す」という基底条件(終了条件)が欠かせません。この条件がないと、関数が自分自身を呼び出す処理が永遠に終わらなくなってしまい、プログラムが正常に動作しなくなります。
再帰処理の身近な例
| 例 | 再帰的な考え方 |
|---|---|
| 階乗の計算 | 「nの階乗」を「n×(n-1)の階乗」として求める |
| フォルダ内の検索 | サブフォルダの中も、同じ探し方で調べていく |
ループ処理との違い
| 項目 | 再帰処理 | ループ処理 |
|---|---|---|
| 繰り返しの表現 | 自分自身の呼び出し | for文・while文 |
| コードの見た目 | 階層的な構造がシンプルに書ける | 手続きが直感的に追いやすい |
| メモリの使用 | 多くなりやすい | 比較的少ない |
メリット
再帰処理を使うと、フォルダの中にフォルダが入っているような、入れ子構造を持つデータを驚くほど簡潔なコードで扱えます。同じ処理を繰り返すためのループを何重にも書く必要がなく、問題の構造をそのままコードに反映しやすいという利点があります。
デメリット・注意点
一方で、呼び出しが深くなるほどコンピューター内部の管理領域を消費し、限界を超えると「スタックオーバーフロー」というエラーで異常終了するおそれがあります。基底条件を書き忘れたり、問題の規模がうまく小さくならなかったりすると、この問題が起こりやすくなります。
再帰処理が向いている場面
再帰処理は、フォルダとサブフォルダ、組織図の上司と部下のように、同じ構造が繰り返し入れ子になっているデータを扱う場面と特に相性が良いとされています。逆に、単純な繰り返しで済む処理であれば、無理に再帰を使わずループ処理で書いたほうが分かりやすい場合も少なくありません。
あわせて知っておきたい用語
- コンストラクタ(Constructor):
オブジェクトを作る際に呼び出される、初期化専用の処理です。 - スタックオーバーフロー(Stack Overflow):
再帰呼び出しが深くなりすぎた際などに起こる、異常終了の一種です。 - ループ処理(Loop):
for文やwhile文を使って、同じ処理を繰り返す仕組みです。 - 関数(Function):
特定の処理をひとまとめにした、プログラムの部品です。
コメント