ファインチューニング(Fine-tuning)とは、すでに広く学習を済ませたAIモデルに対し、特定の目的や自社が持つデータに合わせて追加の学習を行い、モデルの性能や応答内容を調整する手法のことです。日本語では「微調整」と訳されることもあり、生成AIの活用が広がるにつれて頻繁に耳にするようになった用語のひとつです。
現実世界に例えると、ファインチューニングは基礎的な技術をすでに身につけた職人が、特定の分野の専門技術を追加で磨き上げるようなものです。土台となる幅広い知識をゼロから教え直すのではなく、必要な部分だけを重点的に鍛えることで、効率よく専門性を高めます。
ファインチューニング 図解
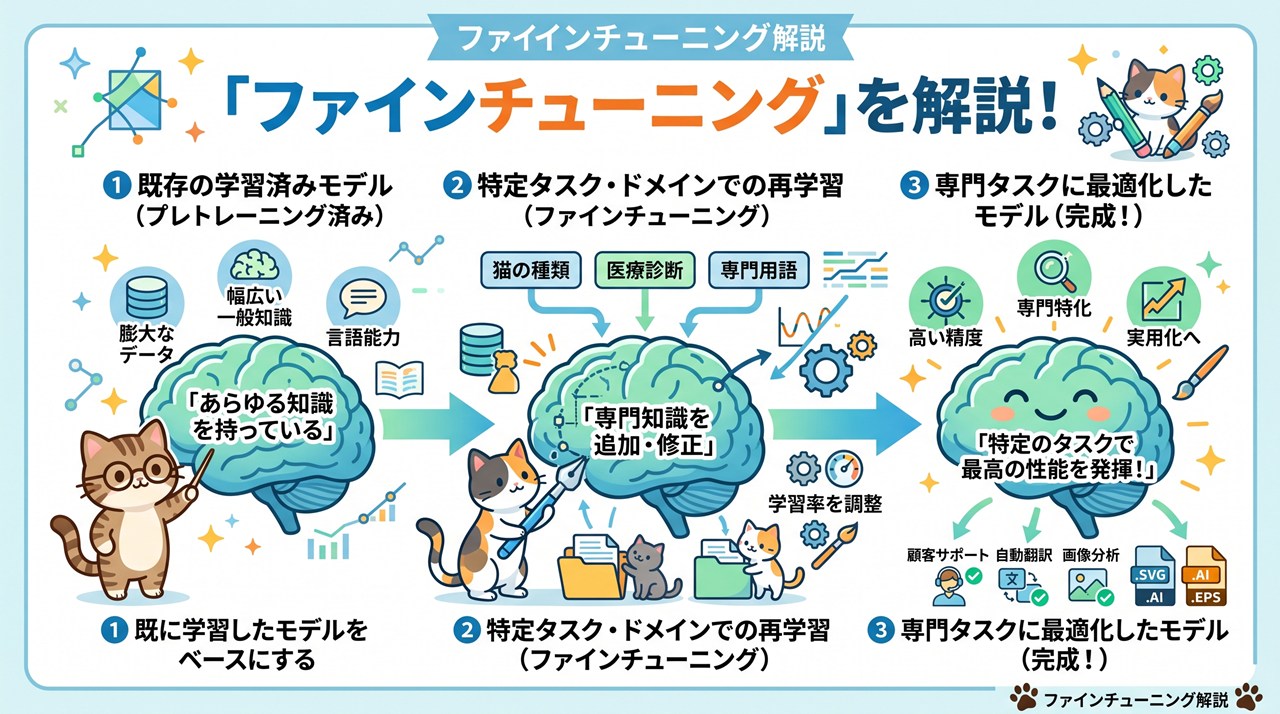
※画像をクリックすると拡大表示します。
ファインチューニングの仕組み
あらかじめ大量のデータで学習された「学習済みモデル」をベースにして、目的に合わせた比較的少量のデータを追加で学習させることで、特定の分野やタスクに適した応答ができるように調整します。ゼロからモデルを作るのに比べ、少ないデータと時間で済むのが特徴です。すでに持っている幅広い知識を土台にできる点が、大きな強みとなっています。
ゼロからの学習との違い
| 方法 | 特徴 |
|---|---|
| ゼロからの学習 | 膨大なデータと計算資源、時間が必要になる |
| ファインチューニング | 既存のモデルを土台に、少量のデータで効率よく調整できる |
学習に必要なデータ量
ゼロから作るモデルには膨大なデータが必要ですが、ファインチューニングでは数百から数千件程度の、目的に沿った質の高いデータがあれば効果を発揮する場合も少なくありません。個人や中小規模の企業でも、比較的取り組みやすい手法として注目されています。
活用される場面
特定の業界の専門用語に対応したチャットボットの構築や、自社の文章の書き方に合わせた文章生成、特定の対象物を見分ける画像認識の精度向上など、汎用的なAIモデルを実際の業務にあわせて活用する場面で広く使われています。
メリットと注意点
効率よく専門性を高められる一方で、追加学習に使うデータの質が低いと、かえってモデルの性能が悪化してしまうことがあります。目的に合った適切なデータを用意し、慎重に調整を行うことが求められます。また、調整しすぎると元々持っていた幅広い知識が失われてしまう場合もあるため、バランスの見極めが重要です。
まとめ
ファインチューニングは、汎用的なAIを実際の業務や目的に合わせて使いこなすための、実践的な技術です。適切なデータと調整により、より自社の用途に合ったAI活用が可能になります。今後もAIの普及とともに、身近な技術として広がっていくと考えられます。
コメント