

EUC-JP(イーユーシージェーピー)とは、UNIX系のOSで日本語を扱うために作られた文字コードのことです。「拡張UNIXコード」の日本語版という位置づけで、かつてはサーバー側の標準として広く使われていました。
現実世界に例えると、EUC-JPはある業界だけで通じていた独自の書式のようなものです。その世界の中では効率よく機能していましたが、外と書類をやり取りする機会が増えるにつれ、共通の書式へ置き換わっていきました。
EUC-JP図解
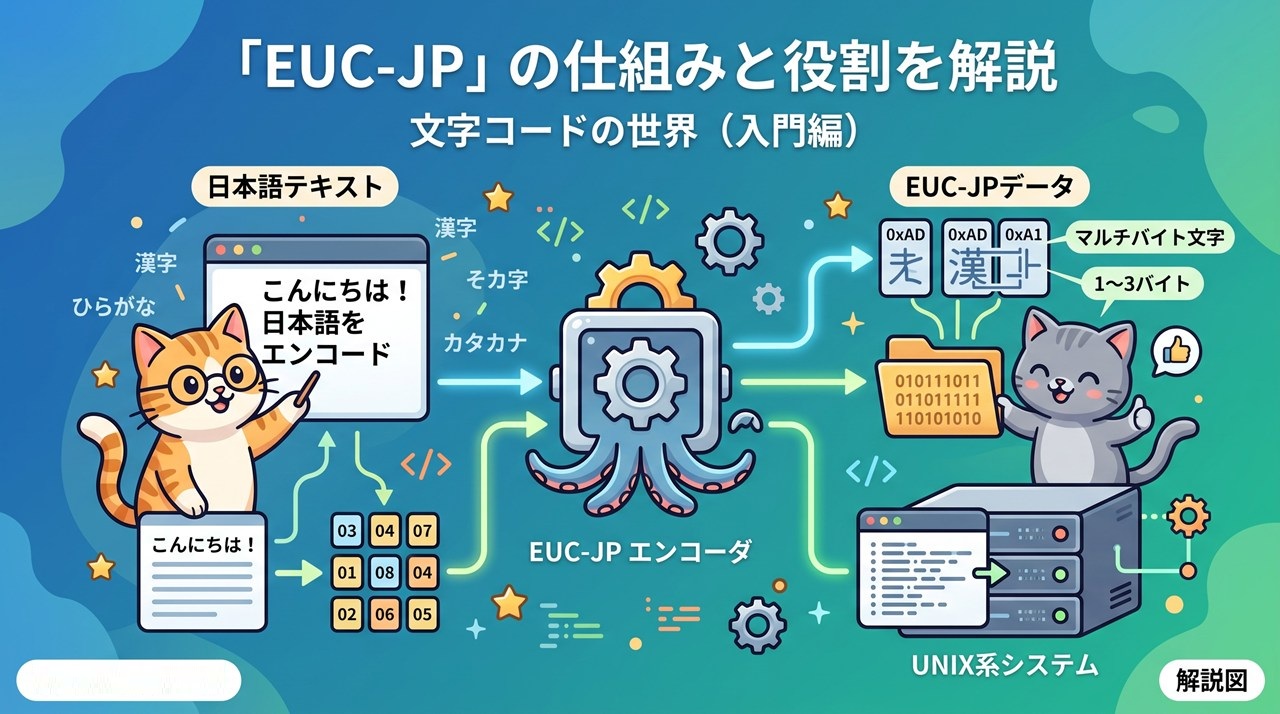
※画像をクリックすると拡大表示します。
日本語の主な文字コード
| 名前 | 漢字の長さ | 主な使われ先 | 現在の状況 |
|---|---|---|---|
| EUC-JP | 2バイト | UNIX系サーバー | ほぼ使われない |
| Shift_JIS | 2バイト | Windows、携帯 | 一部で残る |
| ISO-2022-JP (JISコード) |
可変 | 電子メール | 一部で残る |
| UTF-8 | 3バイト | Web、現在の標準 | 主流 |
ASCIIと共存できる設計
この方式の要になる考え方です。英数字は従来どおり1バイトのまま残し、日本語には2バイト目以降で使われない範囲の値を割り当てて、両者がぶつからないようにしています。そのおかげで、英数字だけを想定して作られた既存のプログラムが、そのまま動き続けられました。
Shift_JISとの違い
同じ2バイトでも作りが異なります。Shift_JISは既存の半角カナを避けて詰め込んだため、2バイト目に記号と同じ値が現れることがあり、プログラムの誤動作を招きました。EUC-JPにはその問題がなく、文字の区切りを見分けやすい点で、扱いやすい設計とされていました。
UNIXの世界で標準になった
広まった経緯です。1980年代後半、UNIX上で日本語を扱う共通の方法として整理され、その後のLinuxや各種のサーバーソフトへ引き継がれました。プログラムの文字処理と相性がよかったため、開発の現場では長くこれが既定の選択になっていました。
Webでも使われていた
過去のサイト構築との関わりです。2000年代前半までは、サーバー側がUNIX系であることから、HTMLやデータベースをこの文字コードで統一する構成が多く見られました。当時作られたページやプログラムの中には、いまもこの指定のまま残っているものがあります。
半角カナの扱いが特殊
実務でつまずきやすい点です。半角のカタカナを表すのに特別な印を付けて2バイトを使う形になっており、他の文字コードとの相互変換で崩れやすい部分でした。そもそも半角カナを使わない運用にするのが、当時から無難な対処とされていました。
UTF-8への置き換えが進んだ
現在の位置づけです。世界中の文字を一つの体系で扱えるUTF-8が普及したことで、日本語専用の文字コードを使う理由がなくなりました。新しく作るものでこれを選ぶ場面はまずなく、いまは古い資産を読むために知っておく知識という位置づけに変わっています。
古いファイルを開くときに出てくる
いま出会う場面を挙げておきます。昔のサーバーから取り出したログや設定ファイル、古いデータベースの書き出しを開いたときに、文字化けの原因としてこの名前が出てきます。テキストエディタで文字コードを指定して開き直せば、多くの場合は正しく読めるようになります。
コメント